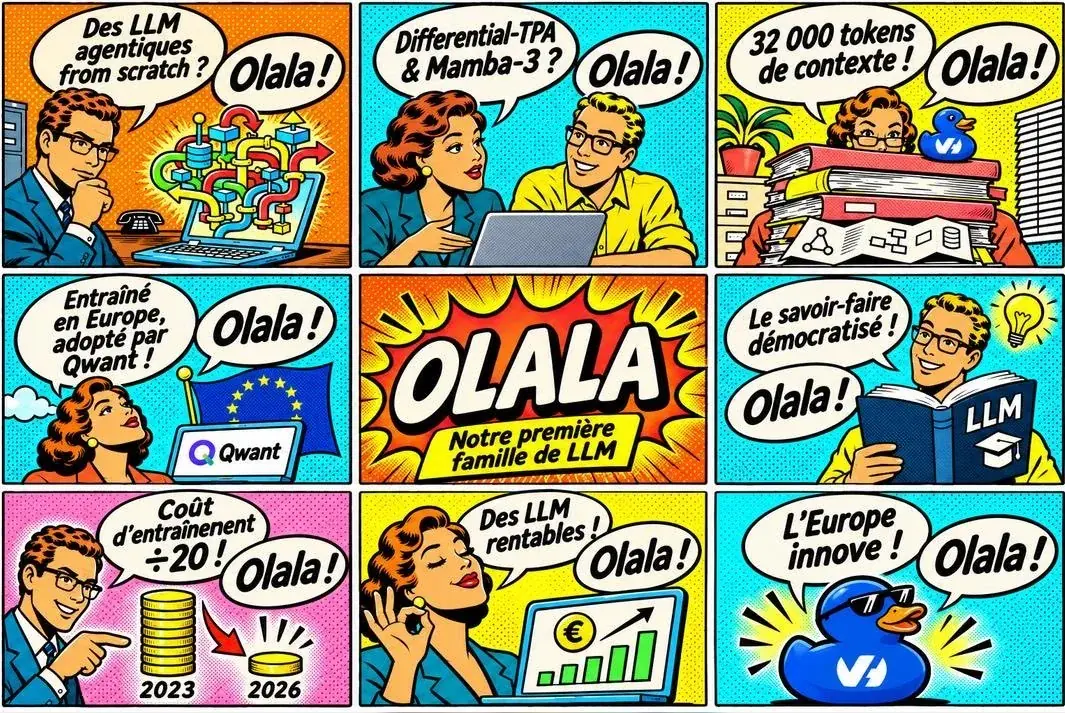
Le roubaisien OVHcloud dévoile Olala, sa première famille de modèles d'IA, entraînée de zéro sur trois supercalculateurs publics européens. Son premier représentant, Olala mini, se contente d'une carte graphique avec 8 Go de mémoire, et tourne même sur un simple processeur. Le modèle arrive jeudi sur Hugging Face, en open source et sous licence Apache 2.0.
Entraînée en Europe
Dans la course aux modèles d'IA français, il y avait Mistral, et il faudra désormais compter sur OVHcloud. L'hébergeur a entraîné Olala mini de zéro, grâce à son laboratoire interne OVHai LLM et à trois supercalculateurs publics : Jupiter en Allemagne, MeluXina au Luxembourg et Jean Zay en France. Les pouvoirs publics ont mis au pot l'équivalent de 7 millions d'euros en heures de calcul. Octave Klaba, le patron d'OVHcloud, assure que le coût d'un entraînement a été divisé par 20 en trois ans, et qu'on ne peut pas juste compter sur la générosité de certains labs pour disposer de modèles ouverts.
Un simple processeur suffit
Olala mini embarque 7 milliards de paramètres, mais un seul milliard se réveille à chaque requête. C'est le principe du mélange d'experts, ici 256 par couche, marié à une architecture hybride d'un nouveau genre. Pour dire ça plus simplement, seule une petite fraction du modèle travaille à un instant donné. Du coup une carte graphique avec 8 Go de mémoire suffit, là où les mastodontes du marché réclament des serveurs entiers, et OVHcloud annonce 160 tokens par seconde sur une RTX A4500, ou encore 50 sur un processeur seul. Pas mal. La fenêtre de contexte, la quantité de texte que le modèle avale d'un coup, est par contre bloquée à 32 000 tokens, la version 1.1 prévue avant la fin de l'année doit la porter à 128 000.
Déjà un premier client
Qwant a basculé le premier. Le moteur de recherche, qui tournait jusqu'ici avec des modèles de Mistral, utilise Olala mini pour générer ses réponses flash, et la maison parle de réponses 20 % plus rapides pour des coûts divisés par trois. Des chiffres d'OVHcloud, à vérifier en conditions réelles, d'autant que Qwant appartient à la galaxie Klaba. Le lancement officiel aura lieu jeudi 19 novembre à Paris, avec la publication des poids, du modèle de base et d'un rapport technique, plus la paperasse de conformité à l'AI Act. Pour la suite, OVHcloud planche sur un Olala 2.0 à plus de 100 milliards de paramètres, décliné pour le cloud, la cybersécurité et les agents d'entreprise, le tout devant alimenter OVHai Workspace, son alternative maison à Microsoft 365.
On en dit quoi ?
Voir un hébergeur français sortir son propre modèle ouvert, ça fait plaisir, et le pari du petit modèle est le bon. Personne n'a besoin d'un monstre à 1 000 milliards de paramètres pour trier des mails ou résumer un PDF, et une IA qui tourne sur le premier PC venu répond à une vraie demande. On attendra quand même les benchmarks avant de s'emballer, un modèle sans le moindre score publié, ça laisse forcément un doute. En tous cas l'idée est courageuse, et ça change des levées de fonds à milliards.